
 Alisina Nawabi
llm-d 1.0 brengt prioriteitssturing, een stabiele configuratie-API en upgrades zonder onderbreking naar de Kubernetes-laag voor gedeelde AI-inferentie, meldt IBM vandaag voor teams die open modellen op eigen infrastructuur draaien.
Dezelfde rekencapaciteit kan daardoor verschillende AI-diensten bedienen zonder dat een piek van agenten interactieve verzoeken verdringt. Een team dat llm-d inzet, beheert nog steeds zelf Kubernetes, versnellers en modellen. De release verschuift het werk van losse technische optimalisaties naar de dagelijkse bediening van een gedeelde inferentiedienst, vooral relevant bij terugkerend verkeer met lange contexten.
De release richt zich op beheer na livegang
llm-d begon in 2025 als gezamenlijk project van Red Hat, IBM, Google Cloud, CoreWeave en NVIDIA. Het project werd in maart 2026 een sandboxproject van de Cloud Native Computing Foundation. De maintainers zeggen dat ruim 500 bijdragers uit meer dan 25 organisaties aan de stack hebben gewerkt. De 1.0-release formaliseert daarmee werk aan een open softwarelaag voor modelbediening die al eerder technieken voor inferentie op meerdere versnellers combineerde.
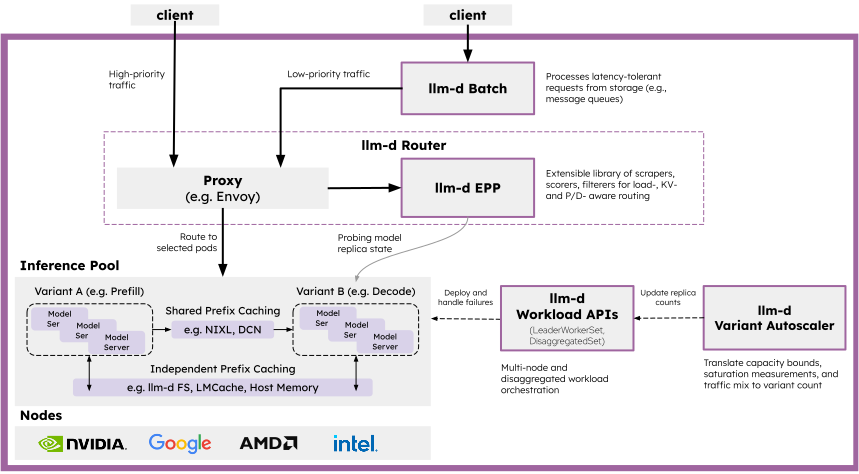
De concrete toevoegingen gaan over wat er gebeurt nadat een model is gestart. Prioriteits- en eerlijkheidsregels moeten voorkomen dat een plotselinge stroom agentverzoeken de antwoorden voor andere gebruikers verdringt. De router krijgt een reservefunctie en kan tijdens gepland onderhoud stapsgewijs worden bijgewerkt. Voor een gesplitste opstelling behandelt llm-d de kopieën voor promptverwerking en tekstgeneratie als één eenheid, zodat die gezamenlijk kunnen worden bijgewerkt. Een stabiele v1-configuratie-API en een versterkt verzoekpad maken dit volgens de projectbeschrijving een vaste basis voor beheer.
Agentverkeer krijgt ook eigen behandeling. De router kan vervolgbeurten naar dezelfde modelkopie sturen waar een deel van de eerdere context nog beschikbaar is. Een prioriteit per beurt en ondersteuning voor opgeslagen toestand van de Responses API zijn bedoeld om herberekening te beperken. De eerdere bouwstenen blijven nodig. Prefixcaching bewaart context voor hergebruik. De KV-cache bevat tijdelijke gegevens van de modelverwerking en kan tussen GPU- en CPU-geheugen worden verplaatst. De stack kan promptverwerking en tekstgeneratie ook in aparte pools onderbrengen. De release brengt die functies samen met verkeerbeheer en upgrades.
llm-d stuurt modelservers op Kubernetes aan
llm-d orkestreert modelservers zoals vLLM en SGLang, terwijl Kubernetes de onderdelen over de beschikbare servers verdeelt. Een team moet dus een Kubernetes-cluster, geschikte GPU’s of andere versnellers, een model en een ondersteunde modelserver kunnen inzetten. De projectrepository biedt geteste configuraties, uitrolrecepten en Helm-charts, maar daarmee is niet elke combinatie van model en hardware gevalideerd. De repository beschrijft llm-d als een open orkestratielaag boven bestaande modelservers en noemt de toetreding tot de CNCF als sandboxproject.
De rekenkracht zelf is een aparte vraag: Together AI draait als eerste klant op IBM’s B300-inferentiecluster, maar capaciteit en klanttoegang zijn nog onbekend. llm-d behandelt de software die verzoeken over zulke rekenmiddelen verdeelt en de dienst tijdens updates beheersbaar moet houden.
De kostenwinst geldt voor een specifieke werklast
Agenten kunnen de kosten per opdracht verhogen doordat ze dezelfde grote context meerdere keren verwerken. Gartner verwacht dat de inferentiekosten per agentische workflow tot 2028 vervijfvoudigen. Cachehergebruik en prioriteitssturing zijn daarom relevant voor de totale rekening, maar een hoog cachecijfer is op zichzelf geen besparing van hetzelfde percentage.
IBM Research schrijft dat de prefixrouter in een recente codeeragenttest 97 procent van het beschikbare cachehergebruik benutte. Dat cijfer beschrijft hoeveel hergebruik de router uit die test wist te vinden, niet hoeveel lager een klantfactuur uitvalt. In een aparte demonstratie zetten IBM Research en Red Hat het open model GLM-5.2, met ongeveer 753 miljard parameters, in op 544 NVIDIA H100-GPU’s. De opstelling verwerkte op een benchmarkpiek 6,6 miljoen outputtokens per minuut en bediende tot 3.000 codeeragenten tegelijk zonder dat verzoeken werden afgebroken. Bij de toen geldende GPU-huurprijzen berekenden de onderzoekers een kostprijs per token die vijf tot tien keer lager lag dan vergelijkbare commerciële API-prijzen, met de grootste verschillen bij veel invoertokens. De benchmark beschrijft de gebruikte hardware, agentbelasting en kostengrondslag.
Dat is relevant voor teams die al GPU-capaciteit hebben en veel herhaalde context verwerken. Het is geen prijskaartje voor elke organisatie. De kostenvergelijking geldt voor één model, een specifieke hardwareopstelling en het tarief voor het huren van die GPU’s. De release bevat geen algemene prijs per miljoen tokens of kostenmodel voor een kleinere, eigen installatie.
Uitval en migratie staan nog op de roadmap
Met productiegeschikt bedoelt de release concrete beheerfuncties. Het is geen kant-en-klare inferentiedienst. De projectroadmap noemt actieve routerredundantie, het overzetten van verzoeken bij uitval, ruimere ondersteuning voor parallelle modelverwerking en verdere koppeling met GitOps als werk voor de volgende fase. De 1.0-release biedt een versievaste configuratiebasis en updates zonder geplande onderbreking, maar de roadmap laat zien dat onderdelen voor uitval en migratie nog verder worden ontwikkeld.
Voor Nederlandse organisaties verandert daardoor vooral de afweging rond een bestaande AI-infrastructuur. Een team met een Kubernetes-platform, GPU-capaciteit en aanhoudende agentbelasting kan de routering en het cachehergebruik naast zijn eigen metingen leggen. Zonder die basis neemt llm-d de kosten van hardware, platformbeheer en beschikbaarheid niet weg. De release maakt die operationele laag concreter; het voordeel hangt af van de hoeveelheid werk die een organisatie er betrouwbaar doorheen kan sturen.
Veelgestelde vragen

AI-inferentie die je beheert
Ik denk mee over de architectuur en bouw AI-diensten die passen bij je eigen infrastructuur en werkprocessen. Van ontwerp en koppelingen tot automatisering en livegang, self-hosted waar dat kan.


Dit artikel is geproduceerd samen met het Agent Team. Meer over de redactie.


