
 Alisina Nawabi
Google Cloud maakt cross-cloudinterconnect en caching voor AWS en Azure algemeen beschikbaar, zodat teams data op afstand via een privéverbinding kunnen bevragen zonder een volledige datasetkopie of variabele kosten voor uitgaand dataverkeer (egress).
Een Nederlandse organisatie met tabellen in het open Apache Iceberg-formaat in AWS of Azure kan die met BigQuery of Managed Service for Apache Spark analyseren zonder een aparte extract-transform-load-pijplijn (ETL) te onderhouden. De kosten verschuiven naar verbinding, cachegebruik en regio.
Externe tabellen worden direct bevraagbaar
Google presenteerde het borderless Lakehouse op 22 april, met Iceberg en een privéverbinding voor analyses over meerdere clouds. De stap van 4 november maakt interconnect en caching voor AWS en Azure algemeen beschikbaar.
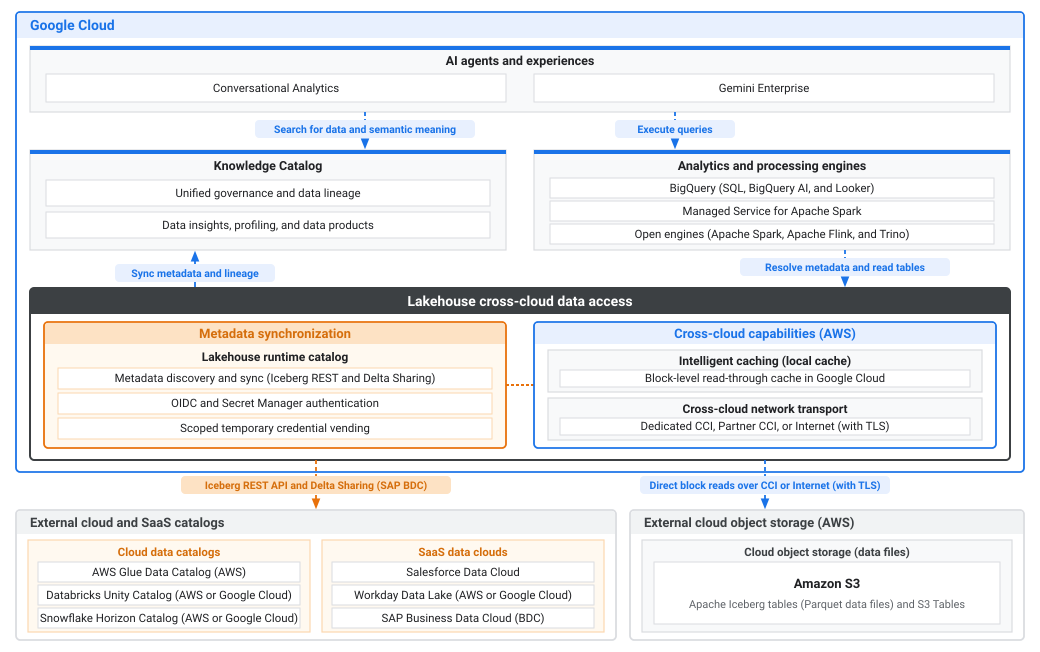
BigQuery SQL en Managed Service for Apache Spark kunnen externe Iceberg-tabellen in Amazon S3 en Azure Blob Storage bevragen zonder bestanden te migreren of een ETL-pijplijn te onderhouden. Gemini kan de tabellen ook met vragen in gewone taal bevragen. Google noemt daarnaast cataloguskoppelingen met Databricks Unity Catalog, Snowflake Horizon en AWS Glue, plus directe koppelingen met SAP, Workday en Salesforce.
Google citeert Delivery Hero’s talabat als voorbeeld: een data engineer zegt dat Iceberg-data uit Amazon S3 via BigQuery de dataverplaatsingskosten met ongeveer 40 procent terugbracht. Streamingtransacties waren volgens hem binnen enkele minuten na productie bevraagbaar. Dit is één klantverhaal, geen algemene besparingsgarantie.
De egressclaim dekt niet alle netwerkkosten
Google zegt dat de nieuwe route geen variabele egresskosten heeft. Google’s documentatie noemt voorspelbare interconnecttarieven en zegt dat caching gratis maar standaard uit is. De besparing hangt af van querypatronen, wijzigingen aan bronbestanden en hoe lang cacheblokken bewaard blijven. Dezelfde blokken vaker lezen kan dus anders uitpakken dan steeds nieuwe data opvragen.
De verbinding zelf heeft een prijs. Google rekent voor een dedicated Cross-Cloud Interconnect-circuit van 10 Gbps 5,60 Amerikaanse dollar per uur en voor een VLAN-koppeling van 1 tot 10 Gbps 0,10 Amerikaanse dollar per uur. Eén circuit dat dertig dagen onafgebroken actief is, komt met één koppeling uit op ongeveer 4.104 Amerikaanse dollar, vóór redundantie of andere clouddiensten. De tarieven voor Cross-Cloud Interconnect rekenen verkeer dat Google Cloud verlaat per gigabyte bij directe CCI. Partner CCI, een vooraf ingerichte partnerverbinding, heeft een apart uurtarief en geen extra kosten per overgedragen gigabyte.
Dit is één directe configuratie, geen universele Lakehouse-prijs. Het kostenplaatje hangt af van verbindingstype, verkeersrichting, queryvolume en hoe vaak de cache gebruikte blokken kan hergebruiken. Google publiceert geen totale voorbeeldrekening voor een gangbare AWS- of Azure-inrichting.
Agenten hebben bedrijfscontext nodig
Data bereiken is iets anders dan de juiste betekenis ervan kennen. Google verbindt het Lakehouse daarom met Knowledge Catalog, dat semantische modellen en bedrijfsdefinities aan data koppelt. Het bedrijf zegt dat agents in eigen tests bijna vier keer nauwkeuriger werden, met tot 33 procent lagere latentie en tot 75 procent minder tokens. Die benchmarks zijn door Google zelf uitgevoerd en niet onafhankelijk gecontroleerd, meldt TechTarget. Het zijn leverancierscijfers, geen voorspelling voor elk Nederlands bedrijf.
Dezelfde beweging is zichtbaar bij open dataformaten. Op 2 november maakte Snowflake Open Data Sharing algemeen beschikbaar voor live, alleen-lezen Iceberg-tabellen die externe afnemers via standaard-Iceberg-REST-API’s kunnen gebruiken. Dat is een andere toepassing dan Googles queries op S3- en Azure-tabellen, maar beide vergroten toegang tot Iceberg-data over platformgrenzen heen.
Agentkoppelingen veranderen ook op andere lagen. Microsoft koppelt Copilot, codeeragenten en n8n aan bestaande Dataverse-records, terwijl Oracle zijn AI Lakehouse voor Iceberg-data over AWS, Azure en Google Cloud uitbreidt. Google richt zich hier op het analyseren van externe tabellen en de context waarmee agents die kunnen interpreteren.
De cache maakt de datalocatie een keuze
De cache bewaart opgevraagde blokken tijdelijk in de Google Cloud-regio waar de query draait. De volledige dataset hoeft niet te verhuizen, maar een deel van de data staat tijdens gebruik wel elders. Lakehouse ondersteunt geen zelf beheerde versleutelsleutels (Customer-Managed Encryption Keys, CMEK). Als een organisatie zulke sleutels verplicht, schakelt Lakehouse caching uit.
Voor Nederlandse teams telt de regioselectie mee. Google koppelt AWS eu-central-1 in Frankfurt aan Google Cloud europe-west3 in dezelfde stad en markeert de combinatie als laag in latency en geschikt voor Partner CCI. De regiomatrix laat zien dat catalogi en verbindingstypen niet overal dezelfde opties hebben. Azure-combinaties moeten afzonderlijk worden gecontroleerd.
De ontwikkeling verschuift agentdata van vooraf gekopieerde tabellen naar queries op data die in een andere cloud blijft staan. Dat kan overdracht en beheer van dubbele bestanden verminderen, vooral als dezelfde blokken herhaald worden gelezen. Tegelijk verschuift de architectuurvraag naar netwerkroute, agentrechten en de plek waar cachedata wordt bewaard. De winst hangt af van hoeveel data een agent kan zien en waar de tijdelijke kopie terechtkomt.
Veelgestelde vragen

Van data naar werkende AI
Ik help van datavraag en architectuurkeuze tot koppeling, ontwerp en automatisering van een werkende oplossing. Self-hosted waar dat kan.


Dit artikel is geproduceerd samen met het Agent Team. Meer over de redactie.


