
 Alisina Nawabi
Decider v1.3 bracht Perplexity op 13 november samen met de kleinere Flash-versie uit; beide modellen krijgen Locate om exacte tekstfragmenten aan te wijzen, schrijft ceo Aravind Srinivas.
Een supportticket kan zo in één API-aanvraag een teamkeuze, prioriteitsscore en het exacte tekstfragment meekrijgen waarop de beoordeling berust. Bestaande software kan de uitkomst naar een wachtrij sturen of een twijfelgeval aan een medewerker voorleggen.
Kansen per vraag, tekst als bewijs
Decider is een beslismodel, geen chatassistent. Je geeft tekst, JSON of een afbeelding mee en stelt vragen met vaste antwoordopties. Het model retourneert kansen per optie, een ja-neekans of een score. Software kan die waarden direct gebruiken in een workflow, zonder eerst vrije tekst naar een label om te zetten.
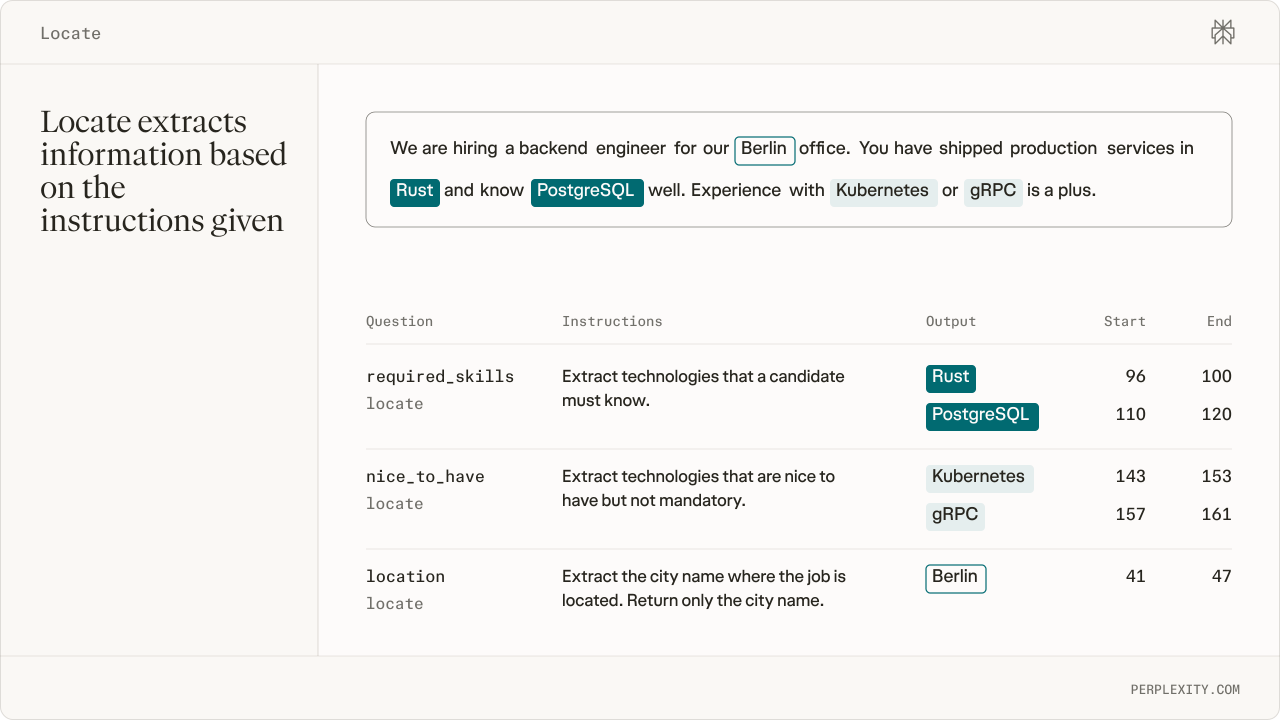
Locate voegt tekstdetectie toe. Je beschrijft bijvoorbeeld een locatie, productcode of persoonsgegeven en krijgt het oorspronkelijke fragment met begin- en eindpositie terug. Bij geen treffer volgt een lege lijst. Perplexity noemt herkenning van namen en persoonsgegevens en het vinden van antwoorden in documenten als toepassingen. Een Locate-verzoek mag maximaal 128 vragen bevatten. Een aanvraag die Locate met gewone beslisvragen combineert, vraagt twee aparte modelberekeningen. Eén API-aanvraag betekent dus niet altijd één berekening.
In een serviceproces kan een ticket tegelijk op team en urgentie worden beoordeeld, terwijl de foutcode als exact tekstbewijs terugkomt. De applicatie voert daarna de route uit. Een kansscore bepaalt niet zelfstandig of een ticket veilig kan worden gesloten.
De API kost centen, zelf hosten vraagt een GPU
Perplexity rekent $0,02 per miljoen invoertokens voor Decider v1.3 en $0,01 voor Flash; uitvoertokens zijn gratis. Tien miljoen invoertokens kosten daarmee respectievelijk $0,20 en $0,10. Dat tarief dekt de modelaanroep, niet de rest van een workflow. Wie actuele webinformatie nodig heeft, betaalt ook voor de zoekstap: de webonderbouwde Decisions API voert één Fast Search-query per vraag uit en voegde in Perplexity’s eigen test 227 milliseconden mediaanvertraging toe.
De v1.3-modelkaart vermeldt Apache 2.0, circa 49 GiB aan gewichten plus extra werkgeheugen, maar zegt ook dat de repository privé is en een toegangstoken vereist. De Flash-kaart noemt Apache 2.0 en circa 8,5 GiB aan gewichten plus extra werkgeheugen. De actuele Hugging Face-metadata zet de v1.3-repository op openbaar en zonder toegangsblokkade. Een gedeeltelijke download van een echt gewichtbestand lukte zonder in te loggen. Ook de Flash-repository staat als openbaar en zonder toegangsblokkade geregistreerd; ook daar was een anonieme download mogelijk. De tokeninstructie lijkt dus achterhaald. De licentie bepaalt wat je met de bestanden mag doen, de repositorystatus of je ze kunt ophalen.
De beslislaag verschijnt bij meer leveranciers
In oktober introduceerde Cloudflare Clef en Clef-flash voor beslissingen in agentworkflows op Workers AI. De gewichten en modelcode van Clef staan onder Apache 2.0 en zijn lokaal te testen. Op 9 oktober stelde Microsoft Decision-1 via Foundry en OpenRouter beschikbaar voor routering, classificatie en workflowcontrole. De 35×-claim van Microsoft ten opzichte van GPT-6 Sol komt uit een mediaanvergelijking zonder absolute responstijden of hardwaredetails.
Die releases maken een aparte beslislaag zichtbaar in AI-software. De routes verschillen: een beheerde API, een modelplatform of gewichten die een organisatie zelf host. Perplexity biedt nu zowel de API als modelbestanden aan. Zelf hosten vraagt de genoemde GPU-capaciteit.
De scorekaart bevat geen Nederlandse proef
Perplexity rapporteert een gemiddelde nauwkeurigheid van 91,6 procent op 63 classificatietaken, 6,54 procentpunt boven de eigen productieclassifiers. De referentielabels zijn opnieuw beoordeeld door een groot taalmodel; de test blijft van Perplexity zelf. Voor Locate testte het bedrijf 17 taken buiten de trainingsdomeinen. De gemiddelde score was 69,0 voor Decider en 63,6 voor Flash, tegenover 43,3 voor Liquid d1. Die uitkomst combineert taakmetingen zoals exact-span F1 en veldnauwkeurigheid; het is geen algemene kans dat een extractie klopt.
De taalproef omvat acht talen: Duits, Spaans, Frans, Italiaans, Russisch, Japans, Koreaans en Chinees. Nederlands ontbreekt. Voor een Nederlandse inbox of documentstroom zegt de scorekaart daarom nog niet hoeveel fouten het model maakt op eigen tekst, namen en categorieën.
Perplexity beschrijft ook een interne beveiligingsproef waarin Decider op één dag een miljard tokens uit 7.000 agentsessies beoordeelde. Daaruit volgden 14 voorgestelde aanpassingen aan beveiligingsregels; zes werden binnen twee dagen goedgekeurd en uitgerold. Bij het opnieuw afspelen van een week aan logs daalde het volume van de drukste regel met 52 procent, terwijl de ruimere regels circa 40 procent meer legitieme acties voor onderzoek opleverden. Dit zijn resultaten uit Perplexity’s eigen omgeving.
Het model levert een gestructureerd signaal, geen afgerond bedrijfsbesluit. Bij routering, escalatie en persoonsgegevens bepaalt de toepassing de drempels en wat bij twijfel gebeurt. Nu meerdere leveranciers beslismodellen aanbieden, tonen de benchmarks vooral hoe elk bedrijf zichzelf meet. Perplexity’s cijfers laten zien wat het automatiseert; hoe vaak dezelfde route de juiste keuze maakt op Nederlandse tekst, publiceert het niet.
Veelgestelde vragen

Van beslislaag naar workflow
Ik denk mee over de beslisregels, ontwerp de datastroom en bouw de route van eerste proef tot live automatisering. Waar het kan, draait die self-hosted.


Dit artikel is geproduceerd samen met het Agent Team. Meer over de redactie.


