
 Alisina Nawabi
OpenMOSS publiceert op 16 oktober MOSS-Image-Base en MOSS-Image-SFT onder Apache 2.0, twee varianten van een beeldmodel waarvan de beeldtransformer 5 miljard parameters telt en tekst en objecten via JSON op vaste plekken zet.
Marketing- en e-commerceteams kunnen vaste beeldindelingen beschrijven en lokaal toetsen of productnaam, prijs en beeldopbouw op hun materiaal aansluiten. De gewichten zijn zelf te draaien, maar de officiële installatie vraagt Python, een NVIDIA-GPU met CUDA en eigen beheer van de modelomgeving.
Een JSON-vak stuurt de compositie
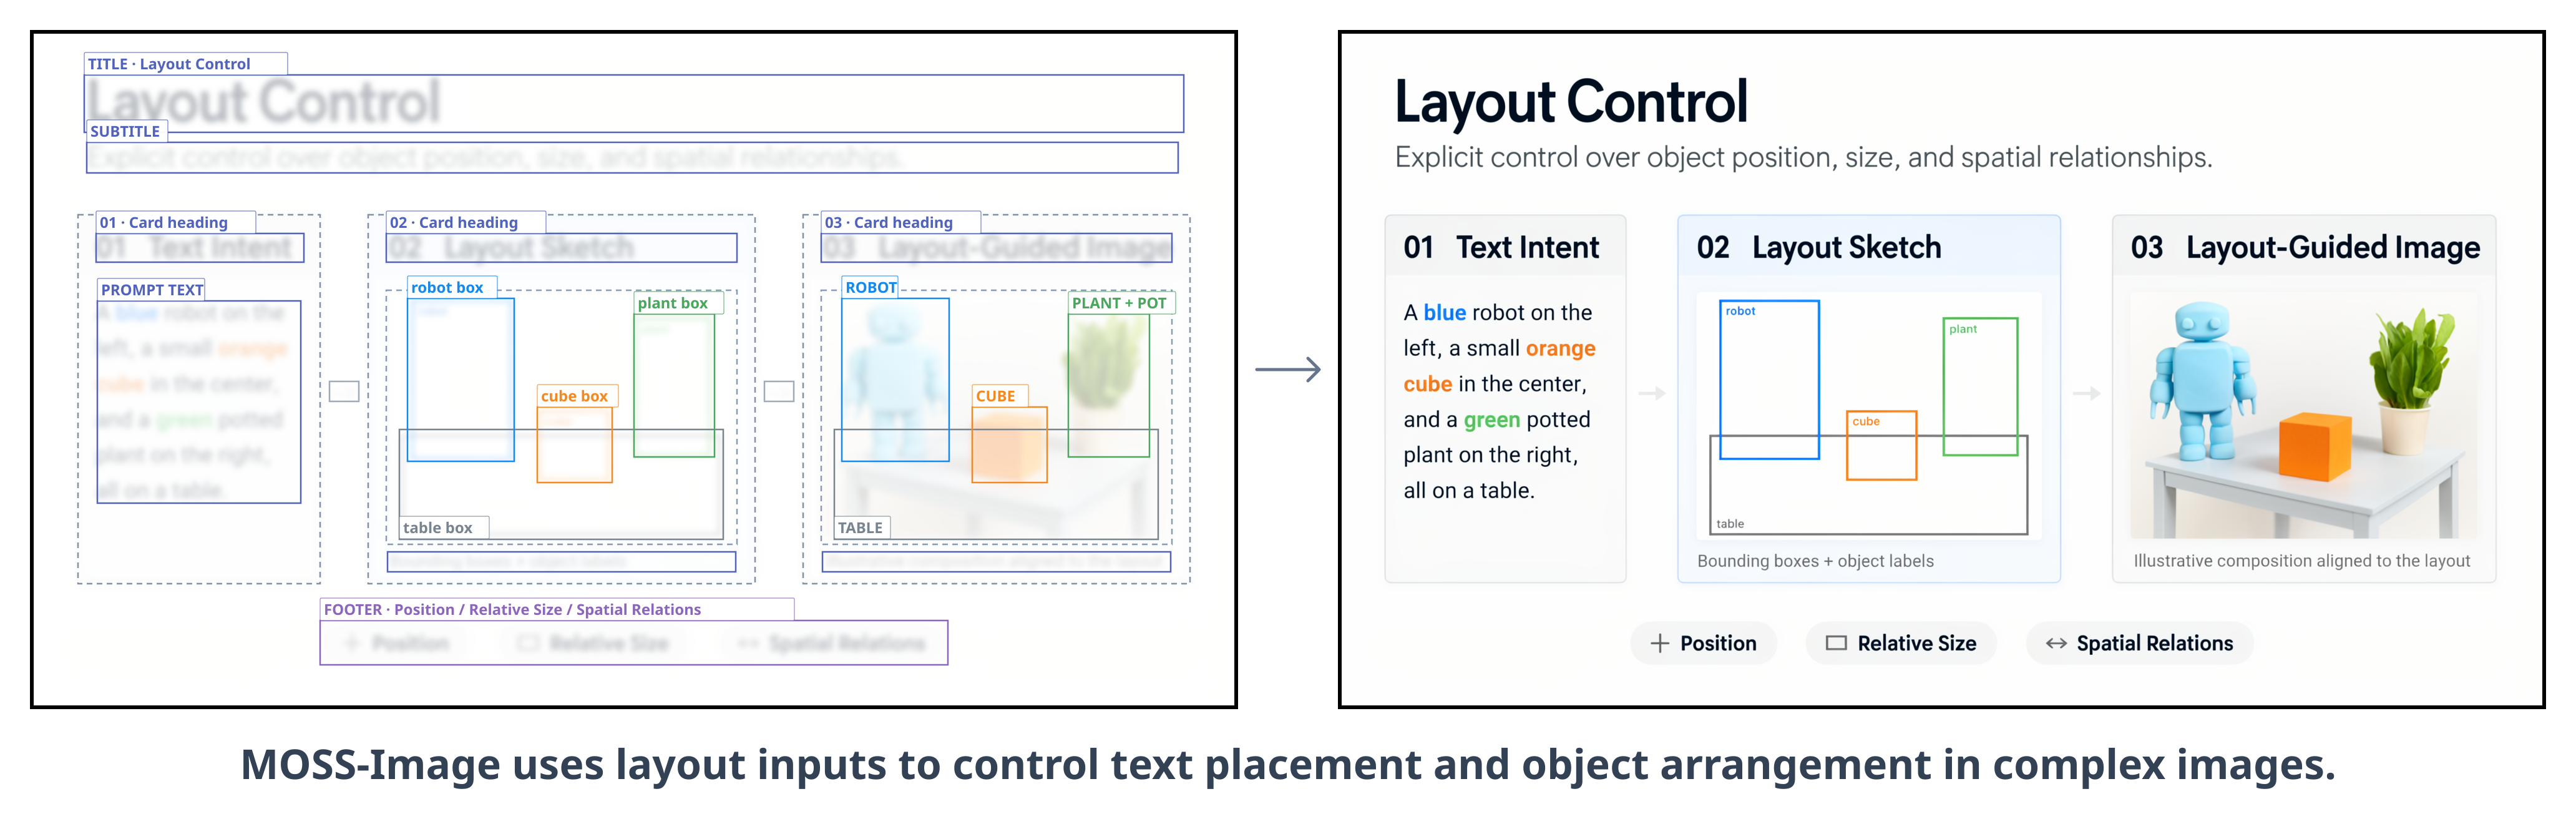
MOSS-Image accepteert gewone beschrijvingen en lay-outs als JSON. summary.caption beschrijft de scène; items bevat per tekstblok of object een label, beschrijving, tekst en coördinaten. Zo kan een prompt een titel bovenaan en een productfoto rechtsonder plaatsen.
In het officiële JSON-voorbeeld staat EXPLORE boven een blauwe bergillustratie op een canvas van 1024 bij 1024 pixels. De coördinaten staan in y/x/y/x-volgorde en worden gemeten vanaf het midden van het canvas. Een team kan zo een advertentie-indeling vastleggen en de tekst of productbeschrijving wisselen. Lay-out wordt daarmee onderdeel van de prompt, maar dat garandeert niet dat iedere merknaam, prijs of kleine regel foutloos verschijnt.

OpenMOSS noemt prompts tot 4K tokens en stijlen van anime tot fotorealisme. Base en SFT delen hun architectuur en invoer; SFT is verder getraind op samengestelde trainingsgegevens. In het whiteboardvoorbeeld van OpenMOSS groepeert SFT tekst duidelijker dan Base, een illustratie van de makers en geen onafhankelijke toets op campagnebeelden.
Beide varianten zijn openbaar beschikbaar
OpenMOSS biedt twee checkpoints. ModelScope vermeldt Base en SFT als publiek beschikbaar onder Apache 2.0 sinds 16 oktober. De Apache 2.0-licentie staat commercieel gebruik van de gewichten toe, zolang gebruikers de licentievoorwaarden volgen. OpenMOSS wijst erop dat pijplijncode en onderdelen van derden andere licenties kunnen hebben, zodat Apache 2.0 niet vanzelf voor de volledige toepassing geldt.
Lokaal draaien vraagt een GPU en beheer
De modelkaart noemt Python 3.10 of hoger, een NVIDIA-GPU met CUDA en 50 beeldstappen in het voorbeeld. Gradio heeft ook een modus die onderdelen tussen CPU en GPU verplaatst, plus een sequentiële modus die minder geheugen gebruikt maar trager werkt. Voor die installatie zijn dus GPU-toegang, modelopslag en tijd voor updates en controle nodig.
De 5B-aanduiding geldt voor de beeldtransformer. ModelScope vermeldt voor Base 13,54 miljard parameters en een download van 27,23 GB; het technische rapport beschrijft daarnaast een Qwen3.5-9B-tekstencoder. Dat verschil is van belang voor de benodigde opslag en hardware. De documentatie noemt geen minimum aan videogeheugen of gemeten aantal beelden per uur. Een online voorbeeld bekijken vraagt geen eigen GPU, maar lokaal testen wel. De release noemt geen prijs per afbeelding of vergelijking met een externe dienst.
Qwen kiest voor minder beeldstappen
Qwen publiceerde een beeldmodel met 7 miljard parameters, 2K-uitvoer en maximaal tien referentiebeelden. De bijbehorende Research License beperkt commercieel gebruik zonder aparte licentie. De Qwen-variant combineert 2K-uitvoer met maximaal tien referentiebeelden. Op 9 oktober verscheen Qwen Image 2.1 Turbo met acht denoisingstappen, herhaalde rekenstappen die ruis uit het beeld halen; de Turbo-aanpak brengt beeldgeneratie terug tot acht stappen.
MOSS-Image legt een ander accent: het maakt ruimtelijke aanwijzingen met JSON expliciet en publiceert de gewichten onder Apache 2.0. De aantallen stappen bieden geen directe snelheidsvergelijking: modellen en instellingen verschillen, en OpenMOSS publiceert geen doorlooptijd per beeld. Qwen gebruikt een korte route voor beeldgeneratie; OpenMOSS legt de nadruk op expliciete plaatsing van tekst en objecten. OpenMOSS biedt een live demo, maar noemt geen prijs of productievoorwaarden.
De meetcijfers komen van OpenMOSS zelf
Het technische rapport rapporteert cijfers voor tekstweergave en plaatsing. Op 7Bench haalt MOSS-Image volgens OpenMOSS 0,88 voor de gemiddelde overlap van objectvakken en 0,70 op de Layout AUC-maat voor lay-outkwaliteit. Voor Ideogram 4 staan in dezelfde tabel 0,44 en 0,20. Voor lange tekst behaalt MOSS-Image in de eigen LongLongTextBench een gemiddelde dekking van 96,3. Die test telt 240 opdrachten in het Engels en Chinees, met gemiddeld 1.339,8 tekens per doeltekst.
Het rapport vermeldt dat OpenMOSS zelf de resultaten op 7Bench, LongLongTextBench en RealLayoutArena heeft verzameld. De score 96,3 is een gemiddelde over zes taal- en lengtecategorieën, geen percentage foutloze advertenties. In een test met 61 korte opdrachten voor posters, infographics en interfaces staat het complete MOSS-systeem tweede met 1.698,70 Elo, achter GPT Image 2 op 1.844,35. Die test omvat ook de promptverbeteraar van OpenMOSS, die bij het genereren GPT-6 gebruikt. Het cijfer meet dus niet alleen de downloadbare Base- of SFT-gewichten.
De release maakt vaste composities een expliciete modelinvoer. De gepubliceerde tests beschrijven wat OpenMOSS zelf heeft gemeten, maar beantwoorden niet hoeveel correctiewerk of verwerkingstijd een bedrijfsproces vraagt. Voor een Nederlandse webwinkel bepalen juist die twee cijfers of vaste tekst- en beeldindelingen op schaal praktisch inzetbaar zijn.
Veelgestelde vragen

Van beeldidee naar werkwijze
Ik denk mee over hoe vaste beeldindelingen in je proces passen, ontwerp de aanpak en bouw die van proef tot livegang. Waar dat kan, houd ik modellen en gegevens op eigen infrastructuur.


Dit artikel is geproduceerd samen met het Agent Team. Meer over de redactie.


