
 Alisina Nawabi
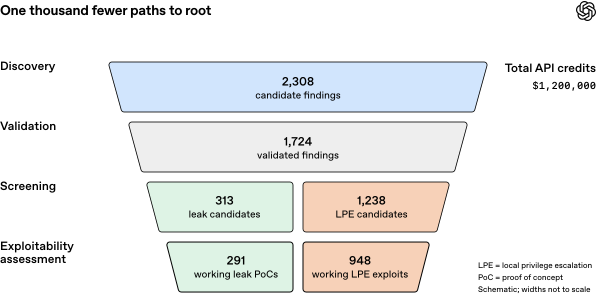
OpenAI meldt op 4 november dat zijn AI-pijplijn 948 unieke Linux-kwetsbaarheden tot werkende privilege-escalatie-exploits bracht en voor elk een patchvoorstel genereerde, voor $1.213.430 aan API-credits.
Wie Linux-servers, cloudimages of apparaten met Linux beheert, moet onderscheid maken tussen een exploit die in een test werkt en een update die op zijn systemen is beland. De 948 zijn geen telling van actief misbruikte zero-days: OpenAI beschrijft een gecontroleerde scan, terwijl fixes nog door onderhouders, distributies en leveranciers heen moeten.
Van 2.308 kandidaten naar 948 unieke lekken
De run draaide medio oktober op de nieuwste Linux-kernel. De analysefase leverde 2.308 kandidaatbevindingen aan. Triage-agents probeerden die in geïsoleerde virtuele machines te reproduceren. Binnen 30 uur waren 1.724 kandidaten reproduceerbaar, meldt Help Net Security op basis van het OpenAI-rapport. Dat is 74,7 procent. De meeste overige kandidaten vroegen hogere rechten of konden door timingproblemen en andere specifieke omstandigheden niet binnen de testtijd worden bevestigd.
Een tweede selectie hield 313 kandidaten voor informatielekken en 1.238 voor lokale privilege-escalatie over. Bij een LPE kan iemand met een gewone lokale account root-rechten krijgen. De VM’s draaiden een standaarddesktopinstallatie met gangbare beveiligingen aan, niet een verzwakt doelsysteem. Dat zegt nog niets over elke kernelversie of distributie.
De agents maakten 291 werkende proof-of-concepts voor informatielekken en 1.169 werkende LPE-exploits. OpenAI groepeerde varianten die bij dezelfde fout hoorden en telde zo 948 unieke kwetsbaarheden en patchvoorstellen. De volledige run kostte $1.213.430 aan API-credits, of $1.279 per unieke LPE. OpenAI merkt zelf op dat het onderzoek vooral modelmogelijkheden mat en niet de kosten optimaliseerde; betere inrichting kan die rekening verlagen.
In juli vond OpenAI’s GPT-5.6 Sol-run 166 unieke LPE’s voor $513.690. De oktober-run leverde meer dan vijf keer zoveel op na drie maanden verdere kernelhardening. In een steekproef van 166 exploits identificeerde OpenAI tien technieken die externe kernelexperts niet eerder kenden; details bleven om veiligheidsredenen vertrouwelijk.
De patchstatus is een momentopname
Beveiligingsonderzoekers beoordelen exploit, patch en ernst voordat rapporten naar Linux-onderhouders gaan. OpenAI zegt dat het honderden rapporten en patches voor kritieke fouten verstuurde en de rest via Patch the Planet-partners geleidelijk meldt.
Na tien dagen waren de scan en handmatige analyse klaar; toen waren 61 LPE’s upstream gepatcht, hadden 43 een stagingpatch en werden 299 publiek besproken, aldus Techzine. In het rapport is dit de stand aan het einde van de analyse; een nieuwe peildatum voor 5 november staat er niet bij. Een stagingpatch is nog geen algemeen uitgerolde update. Het rapport geeft ook geen openbare lijst die iedere bevinding koppelt aan een kernelversie, distributiepakket en uitrolstatus.
Een upstream-fix moet nog in een distributie worden opgenomen, getest en bij de organisatie geïnstalleerd. De cijfers tonen dus activiteit bij kernelonderhouders, niet hoeveel van de 948 al op Nederlandse productieservers zijn verholpen.
Linux bouwt voort op OpenAI’s eerdere beveiligingswerk
In juni meldde OpenAI dat Codex Security ruim 30 miljoen commits in meer dan 30.000 codebases had gescand en meer dan 70.000 fixes door mensen waren bevestigd. Dat werk draaide om kwetsbaarheden vinden en patches controleren. De Linux-run gaat een stap verder in één specifieke codebasis: agents valideren kandidaatlekken, laten zien dat een gewone lokale gebruiker root kan bereiken en bereiden patches voor menselijke beoordeling voor.
Een andere casus volgde op 21 oktober, toen PHP fixes uitbracht voor twee kritieke fouten die code-uitvoering op afstand mogelijk maakten na AI-ondersteund onderzoek. Dat waren twee fouten in een programmeertaal; de Linux-scan betreft lokale privilege-escalatie in de kernel. De aantallen zijn daarom niet bij elkaar op te tellen, maar samen tonen de gebeurtenissen dezelfde verschuiving: AI-onderzoek levert concrete kwetsbaarheden op, terwijl herstel via projectonderhouders en softwareleveranciers loopt.
De exploit moet ook de juiste fout raken
OpenAI rapporteert 948 exploits die in een gecontroleerde omgeving werkten. Het rapport zegt niet dat deze resultaten zijn waargenomen bij aanvallen op bedrijven. OpenAI beschrijft een vroege test waarin het systeem 200 succesvolle root-exploits rapporteerde. Menselijke controle ontdekte dat twintig daarvan root bereikten via een andere kwetsbaarheid dan de toegewezen fout. Het team voegde daarna een onafhankelijke controle toe die nagaat of iedere exploit werkelijk de bedoelde fout gebruikt.
Ook de patchgeneratie vroeg meerdere rondes. De eerste voorstellen konden te veel code bevatten, prestatiekosten introduceren of varianten van dezelfde kwetsbaarheid missen. Extra instructies en menselijke iteratie verbeterden de kwaliteit, maar de onderzoekers blijven de patches beoordelen voordat ze bij onderhouders terechtkomen.
Anthropic’s disclosure-dashboard biedt een ander meetpunt: op 2 november telde het bedrijf 5.087 gemelde kwetsbaarheden in 680 open-sourceprojecten, waarvan 629 upstream waren gepatcht. Die jaarmeting is niet rechtstreeks vergelijkbaar met OpenAI’s tien-daagse Linux-scan, maar Anthropic noemt onafhankelijke triage en menselijke beoordeling zelf een beperkende stap. Bij beide programma’s loopt het werk dus door na de modeluitvoer: bevestigen, melden, patchen en de fix distribueren.
Voor een Nederlandse organisatie wordt de snelheid van AI-beveiligingsonderzoek pas merkbaar wanneer de fix haar Linux-distributie en eigen systemen bereikt. De 61 upstream patches en 43 stagingpatches waren een vroege status, geen eindpunt. De uitkomst hangt verder af van hoeveel tijd onderhouders, distributies, leveranciers en IT-beheer nodig hebben om een gevonden fout om te zetten in een bijgewerkte machine.
Veelgestelde vragen

Van securityvraag naar systeem
Ik denk mee over de beveiligingsvraag, ontwerp de werkwijze en realiseer de software van idee tot livegang. Waar het kan, bouw ik self-hosted zodat jij grip houdt op data en beheer.


Dit artikel is geproduceerd samen met het Agent Team. Meer over de redactie.


