
 Alisina Nawabi
Baidu maakt Unlimited OCR 2 op 27 oktober vrij onder de MIT-licentie; volgens het bedrijf verwerkt het model lange documenten in één verzoek met behoud van context tussen pagina’s.
Finance- en legalteams kunnen daardoor een volledige contractbundel, jaarverslag of auditdossier door één OCR-aanvraag sturen, in plaats van het dossier vooraf zelf in losse pagina’s te verdelen. Dat verandert de intake van lange documenten. Voor een Nederlandse organisatie blijft de beslissende vraag of bedragen, tabellen en verwijzingen correct blijven wanneer ze over pagina’s doorlopen.
De winst zit tussen pagina’s
De eerste Unlimited OCR verscheen in juni. Baidu’s eerste versie kon met R-SWA tientallen pagina’s in één verwerking uitlezen, binnen de standaardlimiet van 32.000 tokens. Unlimited OCR 2 vervangt die methode door Sparse Reference Sliding Window Attention, afgekort SR-SWA.
SR-SWA houdt per tekststap een vaste set visuele verwijzingen bij, bijvoorbeeld 512 tokens. Baidu zegt dat de rekentijd en het geheugengebruik daardoor bijna gelijk blijven als een document langer wordt. De formulering ‘unlimited horizon’ slaat op lange reeksen binnen een eindig contextvenster.
De modelkaart beschrijft SR-SWA en noemt een NVIDIA A800 met 80 GB als testhardware; dezelfde kaart vermeldt de MIT-licentie. Dat is de genoemde testopstelling, geen opgegeven minimumvereiste. De documentatie laat ook zien hoe de code via SGLang als server draait, met extra instellingen voor lange documenten.
De benchmark telt acht onderdelen
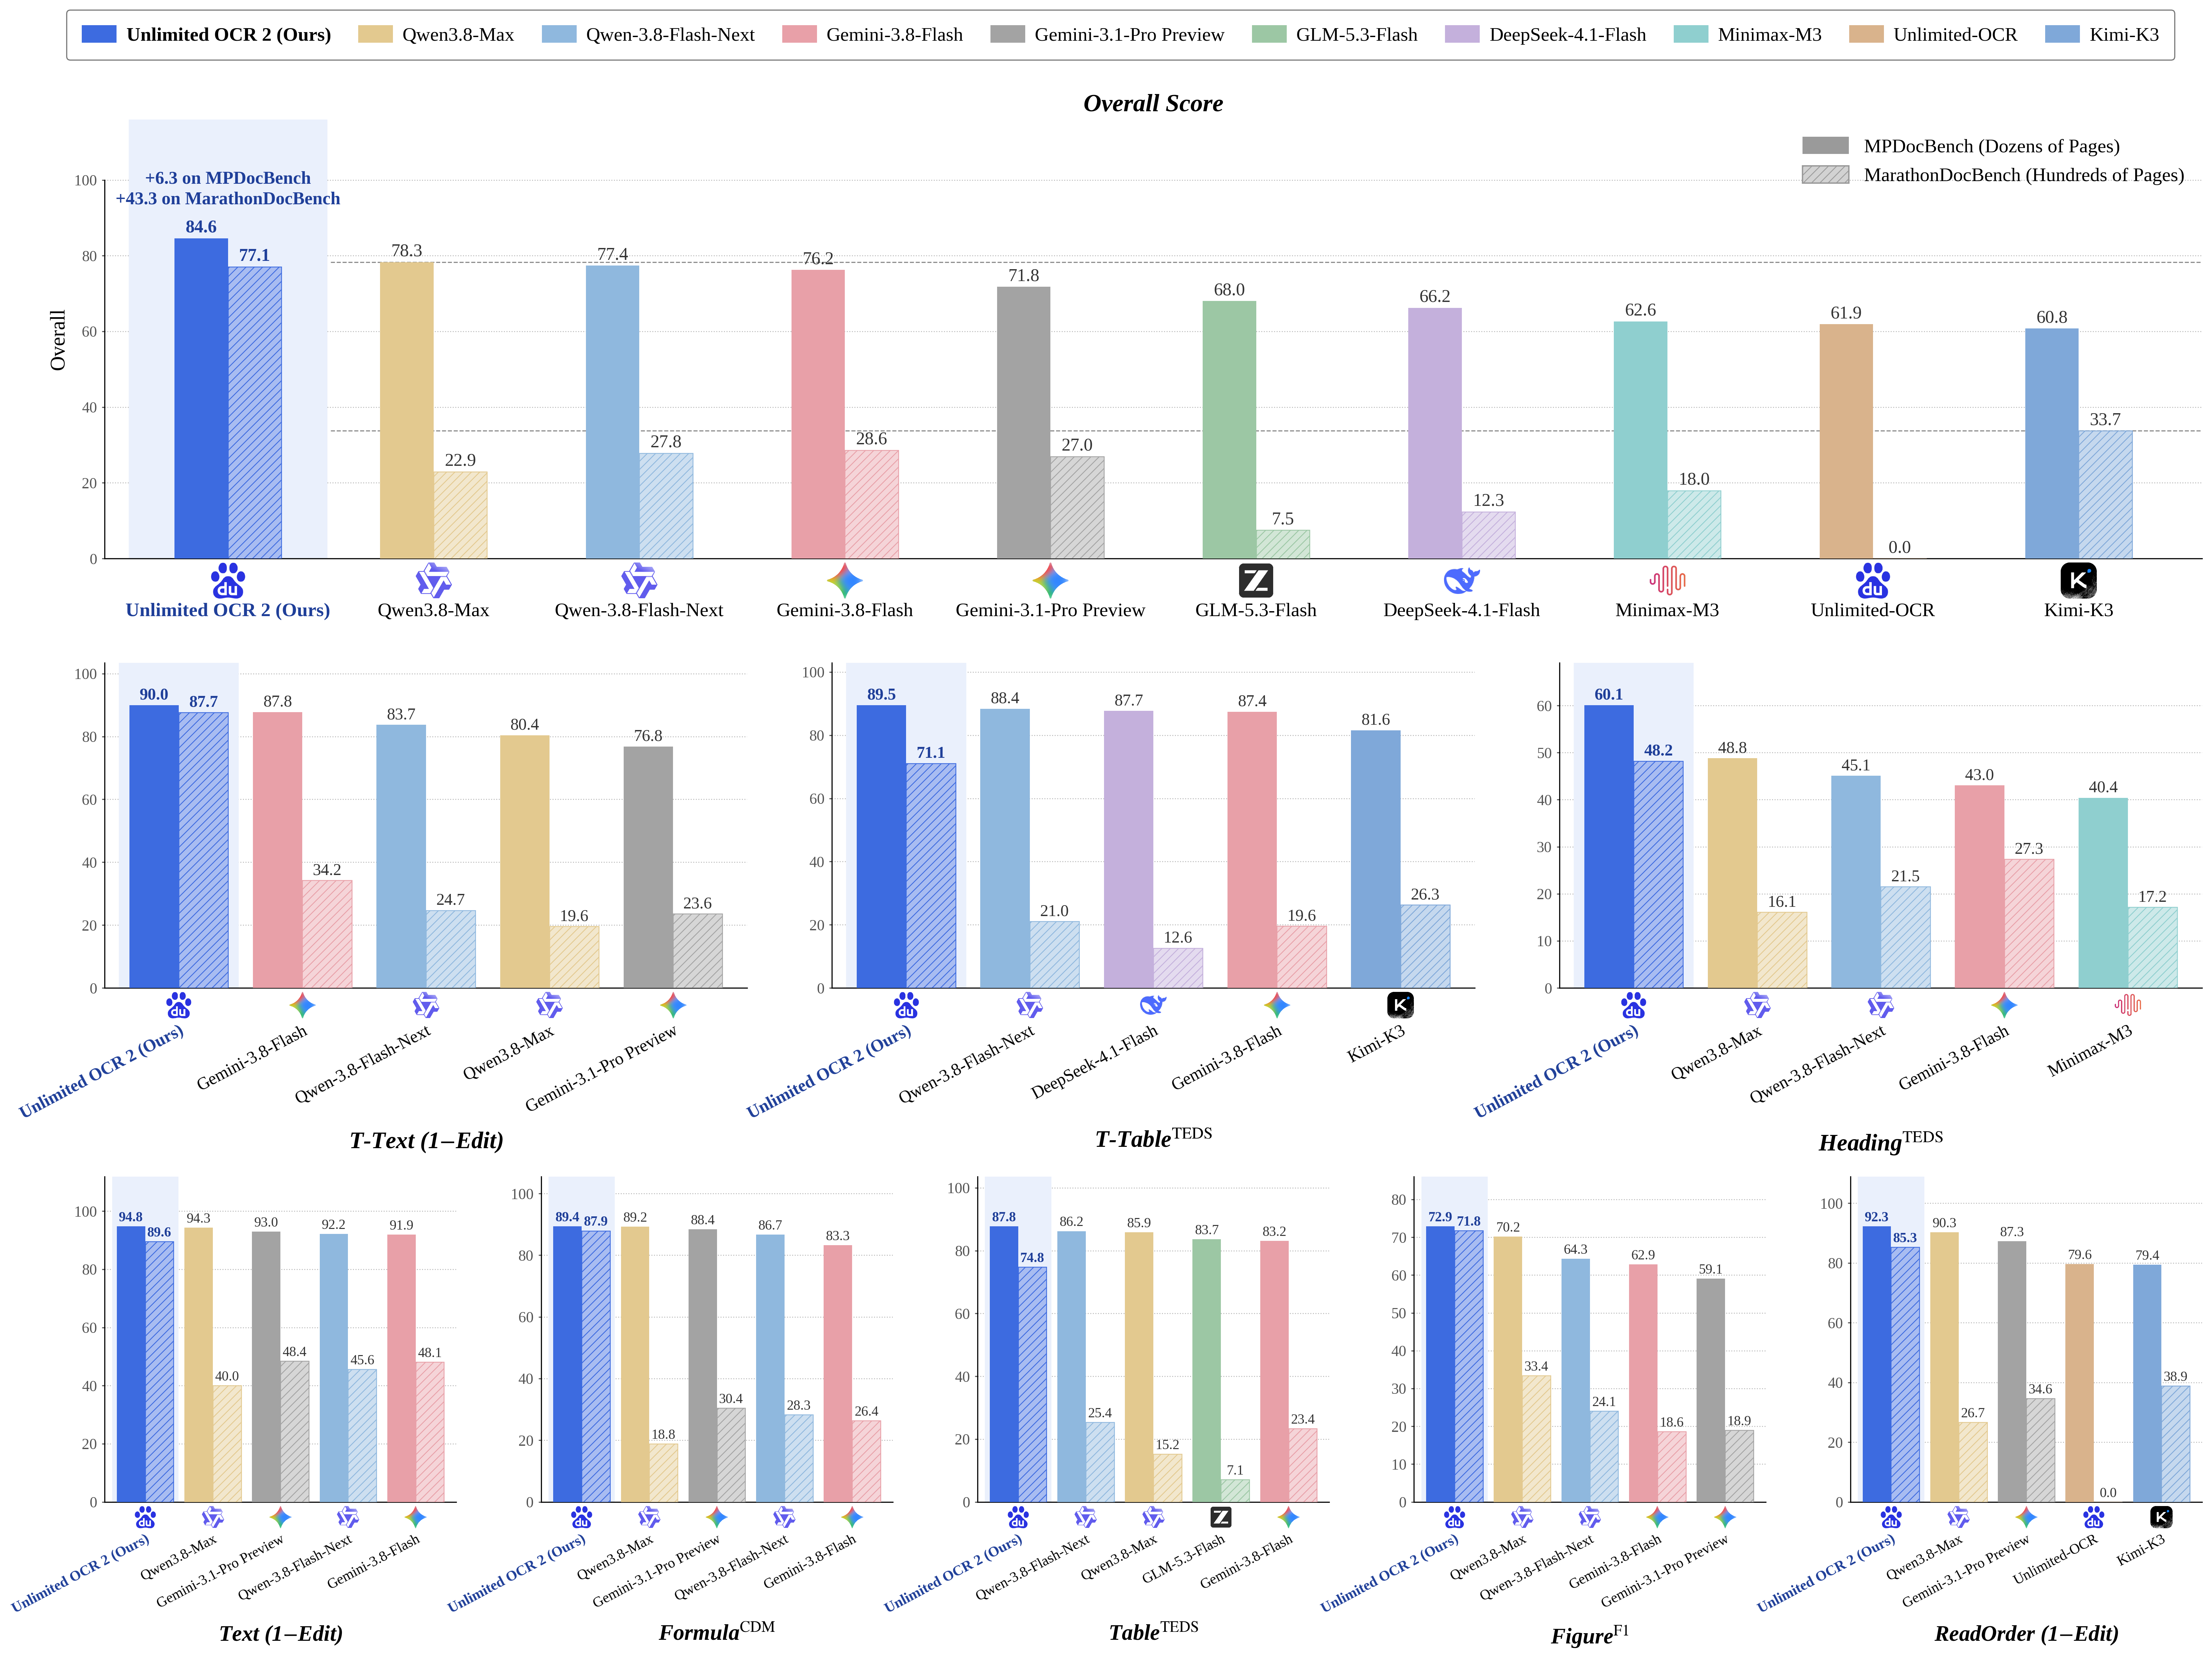
Tegelijk brengt Baidu MarathonDocBench uit: de dataset bevat 100 documenten van 100 tot 300 pagina’s, circa 18.000 pagina’s en ongeveer 205.000 gelabelde onderdelen in het Chinees en Engels. Er staan tabellen en tekst in die over pagina’s doorlopen. Daarmee test de benchmark iets anders dan losse facturen uitlezen: informatie moet tussen verre pagina’s bij elkaar blijven.
Op de benchmarkgrafiek van Baidu behaalt Unlimited OCR 2 84,6 op MPDocBench en 77,1 op MarathonDocBench. Kimi-K3 haalt op de nieuwe set 33,7 en Gemini-3.8-Flash 28,6. De exacte MarathonDocBench-score is 77,06, het gemiddelde van acht metingen voor onder meer tekst, tabellen, formules, leesvolgorde, figuren en koppen. De 84,6 en 77,06 zijn niet rechtstreeks vergelijkbaar: MPDocBench meet tientallen pagina’s, MarathonDocBench honderden.

Pandaily meldde bij publicatie dat onafhankelijke evaluaties nog niet beschikbaar waren. De dataset beschrijft wel hoe de labels tot stand kwamen. Een parser maakte eerste versies, waarna annotatoren de documentstructuur verfijnden. Tekstverschillen werden via een iteratieve controle bijgewerkt en door mensen beoordeeld. De score is daarmee een aanwijzing voor deze testset, geen foutpercentage voor een Nederlands contract.
Nederlandse kwaliteit blijft buiten beeld
De benchmark bevat Chinese en Engelse documenten, geen Nederlandse. Dat bewijst niet dat het model geen Nederlands kan lezen. Het betekent dat de gepubliceerde score niets vaststelt over Nederlandse btw-regels, IBAN’s, komma’s in bedragen of tabellen uit Nederlandse jaarrekeningen.
Mistral kiest bij OCR 4 een ander accent. Het bedrijf zegt dat het model tekstblokken met hun posities en zekerheidsscores teruggeeft en 170 talen ondersteunt. Mistral OCR 4 geeft per woord een zekerheidsscore, classificeert documentblokken en ondersteunt 170 talen. Dat is geen directe vergelijking met Baidu’s lange-documenttest. De twee releases laten wel zien dat document-AI tegelijk ontwikkelt langs herkenningskwaliteit, taalbereik en het vasthouden van verbanden over veel pagina’s.
Voor een proef met Nederlandse dossiers zijn daarom meer uitkomsten nodig dan een totaalscore: klopt ieder bedrag, blijft een tabelrij aan de juiste kolom gekoppeld en verwijst een extractie terug naar de juiste pagina? Een correct uitgelezen factuurbedrag bewijst niet dat de levering klopt of dat de boeking mag worden vrijgegeven. Die controle blijft nodig, ook als het model de tekst herkent.
De serverinstelling bepaalt de grens
Baidu’s documentatie laat alle pagina’s van een bestand in één aanvraag aanbieden, maar de voorbeeldconfiguratie voor SGLang gebruikt bij zeer lange documenten vensters van tien pagina’s. De handleiding waarschuwt dat kleinere vensters het geheugengebruik verlagen, maar dat tekstblokken die over een venstergrens lopen hun context kunnen verliezen. Een instelling voor verwerking van het hele document in één venster is ook beschikbaar. De keuze raakt precies de eigenschap waarop dit model mikt: hoe lang een verband tussen pagina’s intact blijft.
De verschuiving zit in de schaal van de OCR-intake: complete dossiers kunnen in één aanvraag naar het model. Voor Nederlandse finance- en legalteams blijft de feitelijke test hoe bedragen, tabellen en verwijzingen samenhangen op een eigen dossiermix. Dat is het bewijs dat de openbare benchmark nog niet levert.
Veelgestelde vragen

Documenten slimmer verwerken
Ik denk met je mee over de hele documentstroom, ontwerp de controles en bouw de koppelingen en automatisering tot aan je administratie. Waar dat kan, draait de verwerking op je eigen infrastructuur.




Dit artikel is geproduceerd samen met het Agent Team. Meer over de redactie.


